Posts

Обратная сторона корреляции

Image
Часто аналитики делают быстрые выводы исходя из корреляции. Так вот на днях мне попался отличный пример того, как корреляции может вводить в заблуждение. Сегодня я хочу поделиться с вами этим примером. Итак, у нас есть вот такой простой датасет (см ниже). В датасете есть 4 переменные Х и 4 переменные У. Пары значений { xi, yi } подобраны так, что у них практически одинаковая корреляция (~0.816). Так вот одинаковая корреляция еще не означает , что -- между переменными зависимости однотипные Как и высокий коэффициент корреляции еще не означает , что -- между переменными есть  линейная  зависимость -- там вообще есть зависимость Давайте построим 4 графика и оценим эти зависимости. В первой паре { x1, y1 } мы видим практически линейную зависимость. Во второй паре { x2, y2 } мы видим криволинейную зависимость. В третьей паре { x3, y3 } мы видим выброс, который несколько изменил траекторию зависимости. В четвертой паре { x4, y4 } мы видим ...

Outliers, anomalies и прочие выбросы в ваших данных

Image
Часто в ваших данных попадаются выбросы . С точки зрения маркетолога выбросы - это такие данные, которые выходят за ожидаемый диапазон значений. Как с этим работать - тема сегодняшнего поста. Чтобы проще было понимать о чем дальше будет идти речь, я сгенерировал 2 тестовых датасета. Каждый датасет состоит из таких полей: порядковый номер записи (idx),  средний чек заказа (AOV),  средний чек первого заказа (first_AOV). пример данных (10 записей). Первый  датасет состоит из 100 записей и в нем нет outliers (выбросов). Второй  датасет состоит из 30 записей и в нем точно есть outliers (я вручную задал 2 значения выше диапазонов случайных значений, которыми я параметризировал датасеты). Outliers Ожидаемый диапазон значений понятие субъективное (иногда вы можете оценить его адекватно, но чаще - нет). Поэтому здесь лучше опираться на математическую базу. Одно из самых простых и в тоже время рабочих определений дал в свое время известный математик...

Активация клиентов - мощный источник роста бизнеса

Image
Для роста все бизнесы занимаются привлечением новых клиентов. Вы покупаете рекламу и получаете из нее новых клиентов. Это простая и понятная схема. Однако, многие онлайн-сервисы часто предлагают клиенту зарегистрироваться . Здесь, как правило, возможны два варианта: покупка, где в фоном режиме клиента регистрируют в сервисе регистрация, только после которой можно совершить покупку Так вот шаг регистрации (с виду кажущийся незначительным) является важным дифференцирующим фактором, дающим возможность делать интересные исследования. Мысль первая Клиентов, которые зарегистрировались и готовы купить сразу (обычно в тот же день) очень не много . Мы видим, что % клиентов, которые пришли, зарегистрировались и купили в тот же день ( is_same_day_TRUE ) - действительно мало. В примере выше, в зависимости от месяц привлечения, это, в среднем, около 5%. Мысль вторая Занимаясь улучшением привлечения через оптимизацию Landing Pages и Sign Up Forms мы можем улучшить ...

Дисконты, которые могут убить ваш бизнес

Image
После поста " Несколько мыслей о дисконтах ", мой друг data scientist  Sergey Bryl , упомянул о своем опыте анализа клиентов, которые получали дисконты. Смотрел churn rate на одном проекте в разрезе пришел клиент по демпинговой цене или близкой к обычной.   По ритейл-клиентам около 2.5х разница на следующую покупку и на третью уже более 3х.   По "оптовикам" это 6х... до третьей вообще почти никто не доходил. Не долго думая, я решил посмотреть, а как будут обстоять дела с анализом, который я делал в прошлом посте, если я прежде промаркирую клиентов следующим образом: клиенты, которые вообще не пользовались скидками (0) клиенты, у которых скидка была, как минимум, в первую покупку (1) клиенты, у которых скидка была, как минимум, со второй покупки (2+) Посмотрим вначале на доходность на клиента по 3-м группам: На графике просматривается, что медиана у клиентов из группы (1) немного выше, чем у клиентов из группы (0). Т.е. скидка дающаяся на первую...

Несколько мыслей о дисконтах

Image
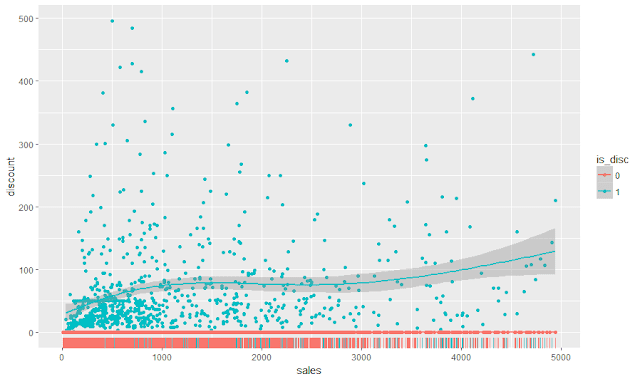
Недавно я выступал на одном мероприятии. И там мы затронули тему дисконтов . Сегодня я хочу немного углубиться в этот вопрос. Начну со своей позиции. Давать дисконты всем клиентам - бессмысленно. Часть клиентов, очевидно, купила бы и так. Сумма дисконта очень тонкий вопрос. Повышение суммы дисконта не гарантирует повышения дохода на клиента.  Перед тем как давать дисконт нужно четко понимать свою цель : сгенерировать покупку, которая не состоялась бы без дисконта повысить средний чек. Обсуждать такой вопрос без цифр достаточно сложно. Поэтому я решил подготовить несколько графиков на базе данных одного из e-commerce. Начнем с начала. Давать дисконты всем клиентам - бессмысленно. Часть клиентов купила бы и так На графике выше четко видно, что клиентов покупающих без дисконта много (на уровне discount = 0 этих точек очень много, а потому они сливаются вместе и фактически образуют сплошную красную линию). Для того, чтобы понять сколько точек слилось вмест...

Кластерный анализ клиентов. Номинал покупки.

Image
Ранее, я в значительной степени полагался на Excel. На мой взгляд, это самый доступный и в тоже время недорогой из аналитических инструментов для маркетолога. Ведь, с одной стороны, Excel есть у многих пользователей. Обмениваться Excel-файлами очень легко. С другой стороны, к отчетам в Excel в значительной степени привыкли топ-менеджеры многих компаний. Однако, со временем, я начал сталкиваться с ситуациями, где надо не просто что-то рассчитать, а понять почему цифра и/или тренд такие, какие есть, найти факторы, которые определили результат. Я активно пользуюсь сводными таблицами т.к. они позволяют быстро делать разные срезы (drill-down) и это дает свои плоды. Часто - но далеко не всегда. В последнее время я больше думаю о базовой математике и алгоритмах, которые стоят за продвинутой аналитикой. Откладывать изучение и использование алгоритмов машинного обучения дальше уже нельзя. Это вопрос выживания для современного аналитика. Для себя я планирую ~ раз в 4 недели описывать свой ...

Карта роста

Image
Десять лет тому назад я активно изучал наработки и практики от лучшей компании по стратегического консалтингу - McKinsey & Company. Если у вас нет свободного времени, то хотя бы прочтите книгу от одного из бывших сотрудников этой компании: Принцип Пирамиды . Именно тогда я познакомился с такими крутыми техниками как MECE и деревья . И вот несколько лет тому назад, готовясь к одной конференции с крутыми ребятами ( Валик Гончаров , Дима Кудренко , Олег Лесов , Андрей Косецкий ) я синтезировал схему, части который я использовал когда оценивал стартапы и/или работал в них. Карта роста. Чем примечательна эта схема? Она проста в понимании. Читая это дерево слева направо, вы понимаете, что и откуда следует. Она практична. Фактически каждый элемент это метрика или вопрос, который м.б. покрыт метрикой. Она совмещает  тактику и  стратегию. Вам не нужно думать, чем бы еще заняться, и в тоже время вы видите картину в целом. Какие недостатки этой схемы? Это схема ...

Retention curve - вчерашний день аналитика

Image
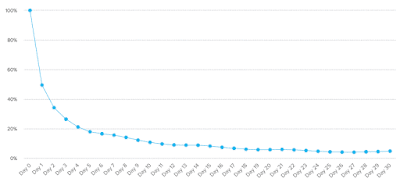
Я давно хотел написать этот пост про retention curve  (кривую удержания). Дело в том, что современная клиентская аналитика развивается очень быстро. SaaS компаний с инструментами аналитики достаточно много. Но не каждая смогла сделать значимый вклад в новые подходы к аналитике. Тем не менее, для себя я могу выделить следующие компании, которые сильно повлияли на мое видение аналитики и на мой подход к онлайн-маркетингу через аналитику. Итак, в 2012 году я равнялся на Kissmetrics.com ; в 2013 это была уже RJMetrics.com ; в 2014 году это была  Custora.com ; в 2015 году это была  Optimove.com И вот в 2016 году я познакомился с think-tank компанией  Amplitude.com . Мое глубокое убеждение в том, что компания предоставляющая аналитический продукт не удержит свои позиции, если будет просто создавать еще один продукт (даже если он будет немного быстрее и удобнее). Аналитическая компания должна искать новые способы выжать больше инсайтов из данных, отобразить су...

ARPU - метрика без измерения

Image
Впервые я познакомился с метрикой ARPU ( A verage R evenue P er U ser) еще в телекоме. Суть ее очень проста - рассчитать среднюю доходность клиента. На языке DAX ее можно было бы рассчитать вот так: ARPU (classic):= SUM (  tbl_orders[payment_amout]  )  /  DISTINCTCOUNT  (  tbl_orders[user_id]  ) Однако в некоторых индустриях (в частности в free-to-play играх) ARPU часто несет несколько иной смысл. ARPU понимают как - среднюю доходность игрока . Игрок может платить, а может и не платить и просто бесплатно играть. Здесь расчет уже использует не только таблицу транзакций, но и таблицу пользователей. ARPU := SUM (  tbl_orders[payment_amout]  )  /  COUNT  (   tbl_users [user_id]  ) Соответственно необходимо ввести еще одну метрику ARPpU ( A verage R evenue P er P aid U ser) - средняя доходность на платящего игрока : ARPpU := SUM (  tbl_orders[payment_amout]  )  /  DISTINCTCOUNT ...

DAU / MAU отличный способ мерять не то, что вам нужно

Image
Впервые я столкнулся с метриками DAU / MAU когда про них упомянули в контексте игр на facebook в далеком 2009 году. И хотя, я уверен, серьезные игроки давно уже не полагаются на эти метрики роста , тем не менее для многих маркетологов они оказались весьма привлекательными. Сегодня мы поговорим почему эти метрики так привлекательны и опасны одновременно. Начнем с их определения. DAU ( Daily Active Users ) это сколько (уникальных) клиентов воспользовались вашим сервисом (обычно - залогинились) в конкретный день. MAU ( Monthly Active Users ) это сколько (уникальных) клиентов воспользовались вашим сервисом за последний месяц (или последние 30 дней).  DAU / MAU это какой % наших (уникальных) клиентов повторно воспользовались вашим сервисом за период. Это так называемый "stickiness". Какие есть плюсы их использования? Первое:  считать такие метрики очень просто. На языке DAX расчеты могли бы выглядеть вот так. [DAU] := DISTINCTCOUNT  ( ...

Customer Retention: как понять, что происходит с клиентами

Image
На днях я прочитал интересную статью от крутой аналитической компании Amplitude. В статье рассказывалось про 3 способа расчета Customer Retention. Сегодня я хочу подробнее изучить результаты применения этих способов на реальных данных. Итак, Amplidude определяет 3 способа расчета Customer Retention: retention at X day Классический подход. Мы формируем когорту клиентов. Затем смотрим, кто из когорты сделал покупку в день Х. retention since X day Более продвинутый подход. Мы формируем когорту клиентов. Затем смотрим, кто из когорты сделал покупку после дня Х. retention in Period Кастомный подход. Мы формируем когорту клиентов. Затем формируем шкалу retention периодов (например, p1 = {d1...d3}, p2 = {d4...d7}, p3 = {d8...d30}). Затем смотрим, кто из когорты сделал покупку в каждом периоде. retention by X day Мой дополнительный вариант. Мы формируем когорту клиентов. Затем смотрим, кто из когорты сделал покупку в периоде {d1...dX}.  Основная идея появления разных расчетов и...

Google Analytics + Power BI Desktop = новые инсайты

Image
Я раньше рассматривал продукт Google Analytics как нечто большое и негибкое. В свое время сам Avinash Kaushik писал о GA как о системе с большом количеством слабо организованных отчетов. Действительно в GA записывается огромное количество интересных данных о поведении пользователей. Писать такие данные к себе в БД накладно, а в GA - ничего не стоит, но выжать инсайты из GA на практике получается редко. Сегодня я попробую объяснить почему так было с GA и что изменилось. Начну с начала. GA состоит из 3-х подсистем: клиентский JS-скрипт, который собирает данные о действиях и перемещениях пользователя на сайте и передает их на GA back-end; GA back-end, который парсит все данные от клинского JS и аккуратно раскладывает эти данные по таблицам (dimensions), создает связи между таблицами, а также делает пред-расчеты; GA front-end (собственно сайт GA), который мы все хорошо знаем и используем, чтобы отфильтровать данные, рассчитать метрики и затем их как-то визуализировать. На мой ...

Удержание клиентов #3: оценка качества клиентов через % one-time buyers

Image
Итак, тема оценки удержания клиентов оказалась довольно сложной. Разные подходы ( экспресс-анализ и анализ периодов в 30d ) обладают своими сильными и слабыми сторонами и каждый из них можно использовать лишь с определенными оговорками. Продолжая тематику удержания клиентов, сегодня я попытаюсь ответить на два важных вопроса: может ли % one-time buyers выступать в качестве прокси фактора, который позволяет спрогнозировать будущее качество когорты клиентов? насколько такой фактор м.б. устойчив со временем (например через 13 месяцев)? Чтобы ответить на эти два вопроса я снова сформирую 12 когорт клиентов, каждая из которых сделала свою первую покупку в соответствующем месяце (1-й месяц, 2-й и т.д.). Для каждой такой когорты я рассчитаю две метрики: % ret 30d (% удержания с шагом в 30 дней) % F1 (% one-time buyers или говоря по-другому - клиентов на одну покупку).  Чтобы оценить зависимости этих двух метрик я построю два scatter-чарта: часть чарта  слева : это ...

Удержание клиентов #2: почему экспресс-анализ неточен?

Image
Итак, я продолжаю серию постов про удержание клиентов. В прошлом посте я рассказал как сделать экспресс-анализ удержания клиентов . Сегодня я расскажу почему экспресс-анализ удержания, сильно оптимистичнее , чем ситуация на самом деле. При экспресс-анализе мы смотрим на то, сколько клиентов перетекает из месяца в месяц. При использовании такого подхода возникают две проблемы: Разные месяца имеют разную длительность (28 vs 30 vs 31 день). Не честно давать одним клиентам на совершение следующей покупки 28 дней, а другим - 31. С точки зрения математики разница во времени составляет 11%! Граница месяца не учитывает, когда клиент сделал покупку. Например, клиент сделал первую покупку 9/20/2012, а вторую 10/1/2012. При выравнивании по месяцу, вторая покупка приходится на следующий месяц (period = 1). Если же считать равными периодами в 30 дней, то выходит, что клиент сделал вторую покупку через 11 дней, т.е. все еще в period = 0. Эти две с виду неважные детали, на самом д...